この記事について
競馬のデータ分析のやり方を、私が実際に「斤量が前走より減った馬のほうが来る」という説を確かめたときの手順に沿ってまとめました。
結論から書きます。競馬のデータ分析は、①説を「何と何を、どの数字で比べるか」に直す ②分ける前の全馬の数字を先に出す ③見かけの差を頭数と一緒に出す ④その差を作っていそうな別の条件で中身を分ける ⑤その条件をそろえて比べ直す、の5つの手順でやります。いちばん大事なのは④と⑤です。ここを飛ばすと、別の理由で生まれた差を「説が正しい証拠」と取り違えてしまいます。
実例に使うのは、凱旋門賞(フランスで毎年10月に行われるG1。ふだんはロンシャン競馬場、2016・2017年はシャンティイ競馬場で開催)の2006〜2025年の20回・出走320頭です。見かけでは、斤量が減った馬のほうが勝率も3着以内に来た割合も高く見えました。ところが、前走のレースの格をそろえて比べ直すと、3着以内に来た割合の差はほぼ消えました(勝率は、斤量が増えた馬の勝ち馬が2頭だけなので比べられません)。どうしてそうなったのかを、順に書いていきます。
競馬のデータ分析のやり方は5つの手順です
データで説を確かめる手順を、凱旋門賞の検証で私が実際に踏んだ順に5つにまとめました。説が中央競馬の話でも海外のレースの話でも、手順は同じです。
- 手順1:説を比べられる形に直す。「何と何を比べるのか」「勝率・3着以内に来た割合・回収率のどれで比べるのか」を先に決めます。
- 手順2:分ける前の全馬の数字を先に出す。条件で分けずに全馬で数えた数字です。これと比べないと、ある条件の数字が高いのか低いのかが分からないので、最初に出しておきます。
- 手順3:見かけの差を、頭数と一緒に出す。割合だけでなく何頭で数えたかを必ず並べます。頭数が少ない組の数字はぶれやすいからです。
- 手順4:差を作っていそうな別の条件で、中身を分ける。差が出た組にどんな馬が集まっているのかを、頭数で数えて確かめます。
- 手順5:その条件をそろえて比べ直す。同じ条件の馬どうしで比べても差が残るかを見ます。残った差だけを信じます。
数えるのに使っているのは、中央競馬のレースならJRA-VANのデータを読んで集計できるソフト「TARGET frontier JV」と、自作のプログラムです。凱旋門賞のような海外のレースは、レーシングポスト(英国の競馬情報サイト)などに載っている過去の結果を集めて数えました。道具の使い方は「競馬予想を自動化する方法|AIにTARGETを操作させる6つの鉄則」に書いています。この記事では、道具よりも「どう比べるか」のほうを書きます。
手順1:説を「何と何を、どの数字で比べるか」に直す
確かめた説は「凱旋門賞では、斤量が前走より減った馬のほうが来る」というものです。斤量は、馬が背負う重さ(騎手と鞍などを合わせた重さ)のことです。
このままでは数えられないので、次のように直しました。
- 比べるもの:前走で背負った斤量と、凱旋門賞で背負った斤量。どちらもポンド(重さの単位・1ポンドは約0.45kg)で比べ、減った馬・同じ馬・増えた馬の3つに分けます。前走の斤量は、レーシングポストに載っている前走の結果から、320頭すべてについて取りました。
- 比べる数字:勝率、3着以内に来た割合、それに日本で馬券が売られた年は回収率も見ます。
「来る」という言葉は、勝つことなのか3着以内に入ることなのかで答えが変わることがあります。だから、数える前に数字を決めておきます。
手順2と3:全馬の数字と並べて、見かけの差を出す
次に、分ける前の全320頭の数字と、斤量が減った馬・増えた馬の数字を並べました。
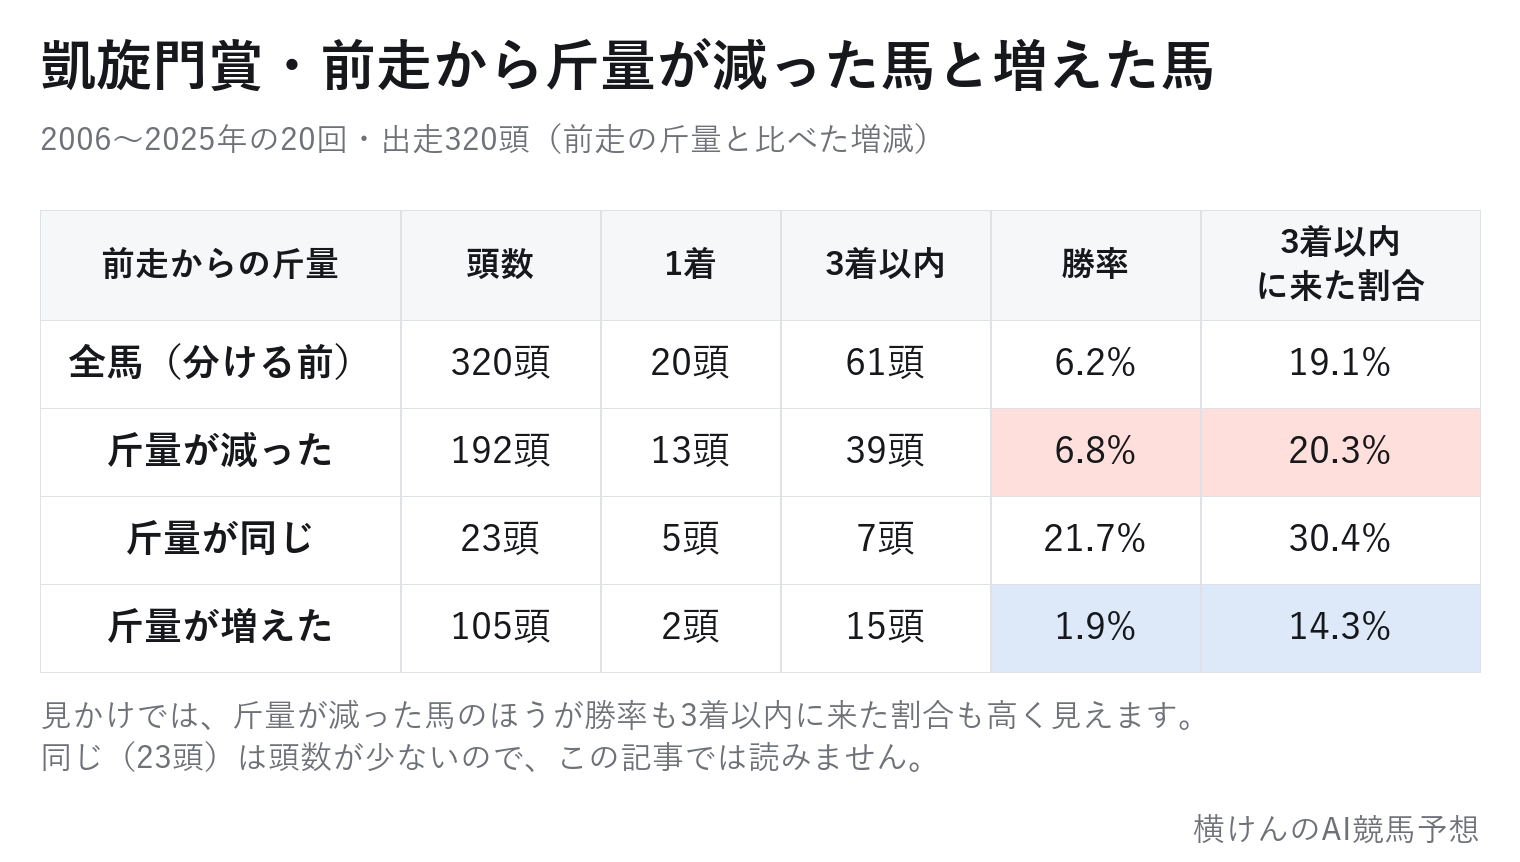
▲ 凱旋門賞2006〜2025年の出走320頭を、前走から斤量が減った馬・同じ馬・増えた馬に分けた表です。いちばん上の行が、分ける前の全馬の数字です。
分ける前の全馬は、勝率6.2%・3着以内に来た割合19.1%です。斤量が減った192頭は勝率6.8%・3着以内に来た割合20.3%で、斤量が増えた105頭は勝率1.9%・3着以内に来た割合14.3%でした。20年の勝ち馬20頭のうち、斤量が減った馬は13頭、増えた馬は2頭だけです。
回収率でも同じ向きでした。日本で馬券が売られた2016〜2025年の10回では、単勝回収率が、斤量が減った100頭で170%、増えた51頭で67%でした。ただし、この2つの数字は、どちらも勝ち馬1頭の配当でほぼ決まっています。減った側の170%は2021年トルカータータッソの単勝110.5倍が押し上げていて、この1頭を抜くと59.8%です。増えた側の67%は、2019年ヴァルトガイストの1勝だけです。回収率は1頭の大きな配当で大きく動くので、ここでも頭数と中身を一緒に見ます。
ここまで見ると、「斤量が減った馬を買えばいい」と言いたくなります。でも、この差が斤量のせいなのか、斤量と一緒に動いている別の何かのせいなのかは、まだ分かりません。ここで止めないのが手順4です。
手順4:差を作っていそうな別の条件で、中身を分ける
凱旋門賞の斤量は、年齢と性別で決まります。賞金や実績では重くなりません。そうなると、「前走から減ったか増えたか」は、凱旋門賞の側ではなく前走のレースで何kg背負っていたかで決まります。
そこで、4歳以上の馬を「どこから来た馬か」で分けて、斤量が増えた馬と減った馬の頭数を数えました。
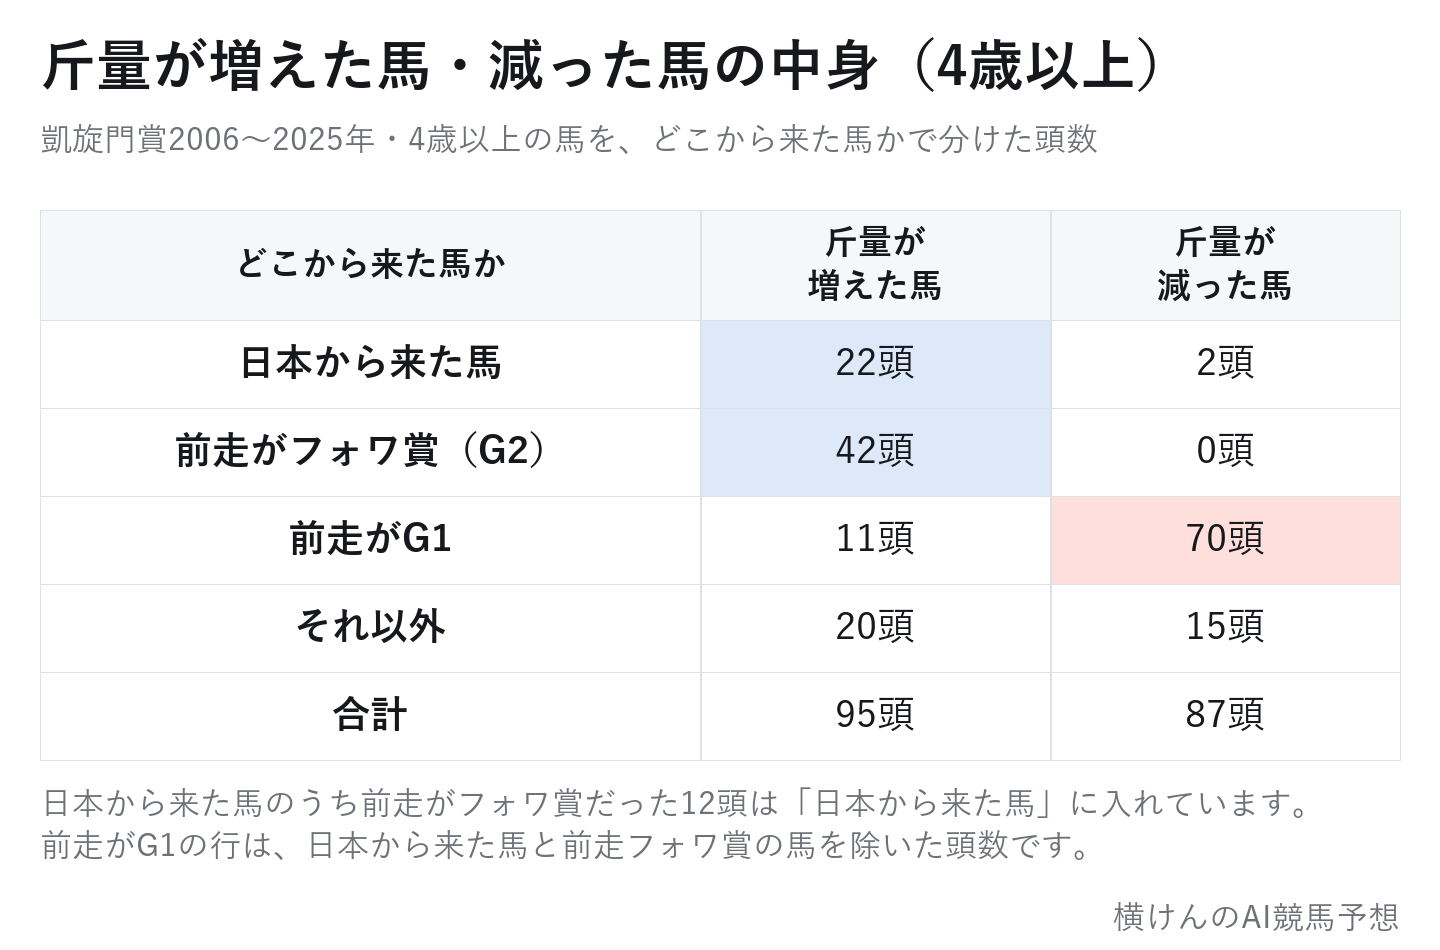
▲ 凱旋門賞2006〜2025年の4歳以上の馬を、日本から来た馬・前走がフォワ賞の馬・前走がG1の馬・それ以外に分け、斤量が増えた馬と減った馬の頭数を数えた表です。
斤量が増えた4歳以上の95頭のうち、22頭は日本から来た馬で、42頭は日本以外の馬で前走がフォワ賞(凱旋門賞の3〜4週間前に同じ競馬場で行われるG2の前哨戦)だった馬でした。日本から来た22頭のうち12頭も、前走はフォワ賞です。フォワ賞は凱旋門賞より斤量が軽いので、フォワ賞から来ると斤量は増えます。日本から来た馬も、22頭が増えて、減ったのは2頭だけです。
反対に、斤量が減った4歳以上の87頭のうち、日本から来た馬を除いて数えると、70頭は前走がG1(愛チャンピオンステークス・バーデン大賞・ヴェルメイユ賞など)の馬でした。日本から来た馬を除いて全年齢で数えると、前走がG1だった馬の割合は、斤量が減った馬で62.3%、増えた馬で19.5%です。
つまり、「斤量が減った馬」はほとんどが前走G1の馬で、「斤量が増えた馬」は前走G2の前哨戦の馬と日本から来た馬が中心でした。斤量の増減と前走のレースの格が、ほぼ重なっていたわけです。
手順5:その条件をそろえて比べ直す
最後に、前走のレースの格が同じ馬どうしで、斤量が減った馬と増えた馬を比べ直しました。日本から来た馬(全年齢で32頭)は外して数えています。日本から来た馬の前走は、日本のレースか、フォワ賞・ニエル賞などの前哨戦にかたよっていて、ヨーロッパの馬と同じ物差しで前走の格を並べにくいからです。
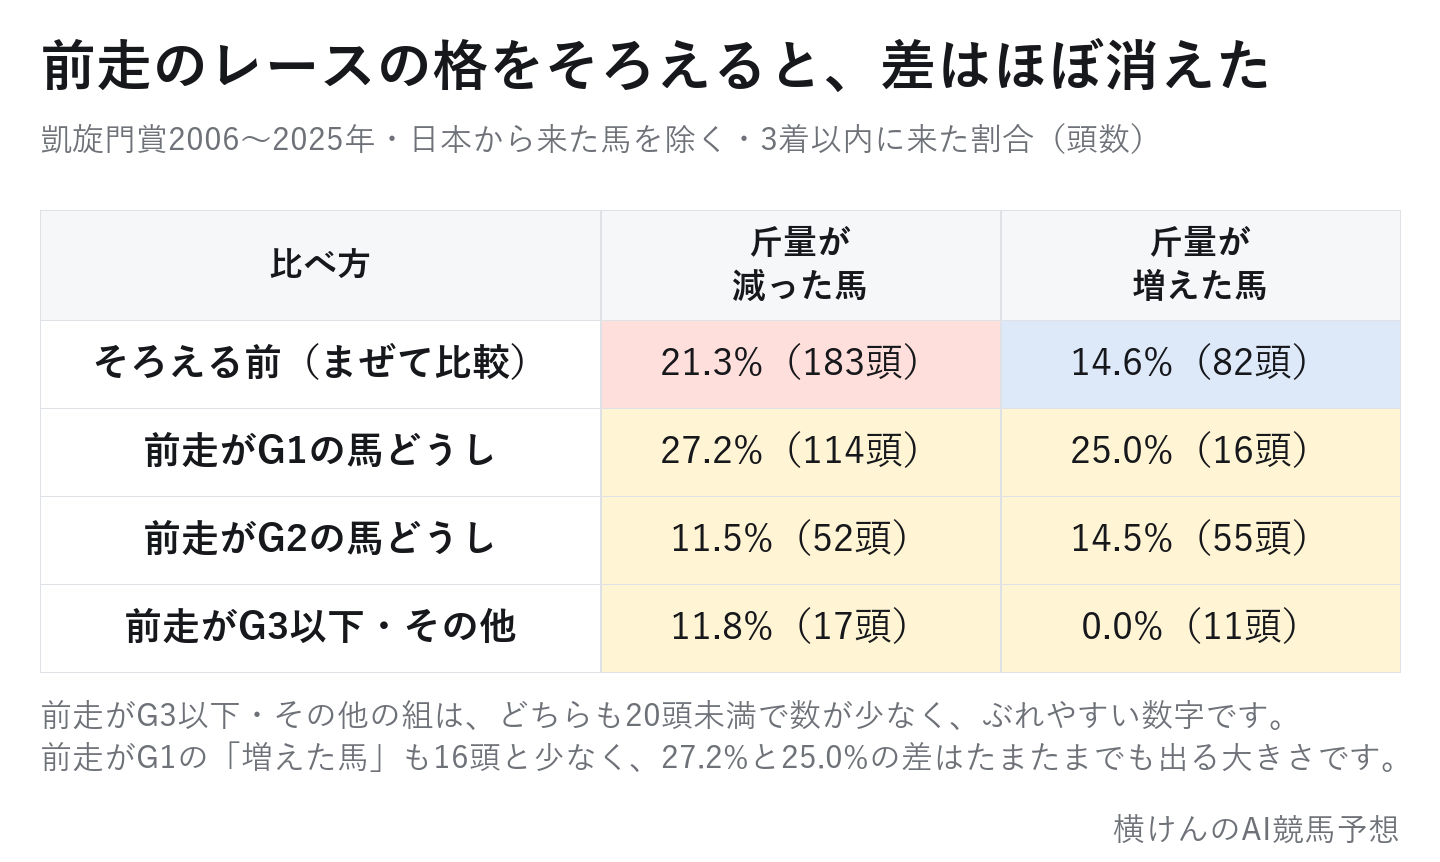
▲ 日本から来た馬を除いた凱旋門賞2006〜2025年の出走馬で、3着以内に来た割合を比べた表です。いちばん上の行がまぜて比べた数字、下の3行が前走のレースの格をそろえて比べた数字です。
まぜて比べると、3着以内に来た割合は、斤量が減った馬が21.3%(183頭)、増えた馬が14.6%(82頭)です。ところが、前走がG1の馬どうしで比べると、減った馬が27.2%(114頭)、増えた馬が25.0%(16頭)で、ほとんど差がありません。増えた馬は16頭と少ないので、この程度の差はたまたまでも出る大きさです。前走がG2の馬どうしでは、減った馬が11.5%(52頭)、増えた馬が14.5%(55頭)で、向きが逆になりました。
一方で、前走のレースの格そのものの差は大きく出ています。日本から来た馬を除いて数えると、3着以内に来た割合は、前走がG1の馬が27.3%(150頭)、前走がG2の馬が13.1%(107頭)でした。
答えはこうです。凱旋門賞の「斤量が減った馬のほうが来る」は、斤量そのものの差は見えず、「前走G1の馬が来る」を別の言い方で見ていたものでした。私はこの結果を受けて、斤量の増減を凱旋門賞の指数の新しいファクター(予想の切り口)にはしていません。前走のレースの格と同じものを二重に数えることになるからです。前走の格で見た凱旋門賞の回収率は「凱旋門賞のファクター別回収率を計算|人気・枠・前走・G1勝ち数」にまとめています。
条件をそろえても差が残れば、それは使える材料です
条件をそろえると、いつも差が消えるわけではありません。消えずに残った差こそ、予想に使える材料です。
たとえば、出馬表で騎手名の横に☆や△が付く減量騎手(見習い騎手)が乗る馬を調べたときは、同じ人気の馬どうしで比べました。人気が低い馬ほど3着以内に来にくいのは当たり前です。減量騎手は人気の低い弱い馬に乗ることが多いので、そのまま全馬と比べると「騎手のせいで負けた」のか「馬が弱いから負けた」のかが分かりません。知りたいのは、同じ人気の馬と比べても、なお3着以内に来にくいかどうかです。そこで1番人気どうし、2番人気どうし……と18の人気帯で1つずつ比べたところ、18の人気帯すべてで、減量騎手が乗る馬のほうが3着以内に来た割合が低く出ました。こういう差は、そろえても消えなかった差なので信用できます。ただし、これは回収率の差ではありません。単勝回収率で見ると、18の人気帯のうち7帯は減量騎手が乗る馬のほうが上回っていて向きがそろわないので、「消せば儲かる印」ではなく、3着以内に来る確率の見積もりを正す材料です。詳しくは「減量騎手が乗る馬は不利か|25万頭を同じ人気で比べた3着内率」に書いています(3着内率は、3着以内に来る割合のことです)。
そろえる条件は、説ごとに変わります。凱旋門賞の斤量では前走のレースの格、減量騎手では人気でした。「この差と一緒に動いていそうなものは何か」を考えて、中身を頭数で数えてみる。それが手順4です。
後から見つけた条件は、先に約束してから確かめる
データ分析で、もう1つ気をつけていることがあります。数字を見たあとで見つけた「よく当たる条件」は、それだけでは証拠にしないことです。
私は自分の予想の自信度(1〜5の5段階)を、別の計算方法で出し直した「M3+10」という物差しを作りました。2026年7月19日〜10月4日の1勝クラス以上で、私の本命365頭を数え直すと、いまの自信度は5ではなくM3+10だけが5だった本命68頭は、複勝回収率131.5%でした。
ただ、この68頭の組み合わせは、数字を見たあとで見つけたものです。たくさんの切り方を試せば、たまたま良く見える組は必ず出てきます。そこで私は、M3+10を予想の表に表示する前に、「表示を始めた開催日から42開催日ぶんの記録で判定し、それで決まらなければ84開催日ぶんでもう一度判定する」「途中で覗いて良い・悪いと言わない」と記録に残しました。最初の判定は2027年2月末〜3月ごろになる見込みです。たまたま良く見える組の見分け方は「特徴量の採用基準の作り方|3534回試して分かったまぐれ率」に、予想より後の数字が混ざって成績が良く見える落とし穴は「競馬データ検証の罠|予想より後の数字が混ざると成績は良く見える」に書いています。
よくある質問
競馬のデータ分析には、何のデータを使えばいいですか?
私は、中央競馬のレースはJRA-VANのデータを、TARGET frontier JVと自作のプログラムで読んで数えています。海外のレースは、レーシングポストなどに載っている過去の結果を集めました。どのデータを使っても、5つの手順は同じです。
何頭くらいあれば、数字を信じていいですか?
決まった線はありませんが、頭数が少ない組の数字は大きくぶれます。この記事の凱旋門賞の表でも、前走がG3以下・その他の組は、斤量が減った馬が17頭、増えた馬が11頭で、増えた馬の3着以内に来た割合は0.0%でした。この組は数が少なすぎるので、結論には使っていません。割合と一緒に必ず頭数を見て、少ない組は読まないと決めておくのが安全です。
まとめ:条件をそろえて残った差だけを積み上げます
競馬のデータ分析のやり方をまとめると、次の5つの手順です。
- 説を「何と何を、どの数字で比べるか」に直す
- 分ける前の全馬の数字を先に出す
- 見かけの差を、頭数と一緒に出す
- 差を作っていそうな別の条件で、中身を分ける
- その条件をそろえて比べ直し、残った差だけを信じる
凱旋門賞の斤量の説は、この手順で「前走の格を見ていただけ」と分かりました。その代わりに、日本から来た馬を除くと、前走がG1の馬は3着以内に来た割合が27.3%と、前走がG2の馬の13.1%の約2倍あるという、本当に使える物差しがはっきりしました。説が1つ消えても、そのたびに本物の材料が1つ手元に残ります。
私は毎週150万円を馬券に賭けながら、気になった説を1つずつこの手順で確かめ、消えた説も残った説も数字ごとこのブログに書いています。条件をそろえても残った材料が積み上がっていけば、予想は少しずつ前に進みます。私が先に数えて確かめた結果を、これからも毎週ここに出していきますので、ぜひ一緒に追いかけてください。
この内容を実際に使った週の実戦記録(買い目と収支つき)はこちらです。→ 競馬が当たりやすい時と当たりにくい時|多頭数の日曜は印4番手が4勝
▶ 私が毎週150万円を賭けながら3年かけて作った競馬予想AIの全体像は、「競馬予想AIの作り方・完全ガイド」に最初から順にまとめています。
コメント