競馬のデータを自分で集計していると、ときどき「この条件は儲かる」という当たりを引きます。私も3年やってきて、何度も引きました。ところが、いざその条件で実際に馬券を買うと、集計で見えていたほどの数字は出ません。
原因の多くは、馬の見方ではありません。集計の作り方のほうです。しかも、いちばん多い壊れ方は毎回これです。予想を出す時点ではまだ存在していなかった数字が、集計に混ざっている。
この記事では、私が今月実際に見つけた混入を3つ並べます。どうやって気づいたのか、そして二度と入らないようにするために何を決めたのかを書きます。競馬の話として書きますが、過去のデータで何かを検証する仕事なら、どこでも同じことが起きます。
▶ 私が毎週150万円を賭けながら3年かけて作った競馬予想AIの全体像は、「競馬予想AIの作り方・完全ガイド」に最初から順にまとめています。
まず引くのは「予想を出す時点」の線
私は毎週、レースの前日の夜に印を決めて公開しています。ですから私の予想にとっての境目は前日の夜です。この線より前に発表されていた数字は使ってよくて、この線より後にしか分からない数字は使えません。
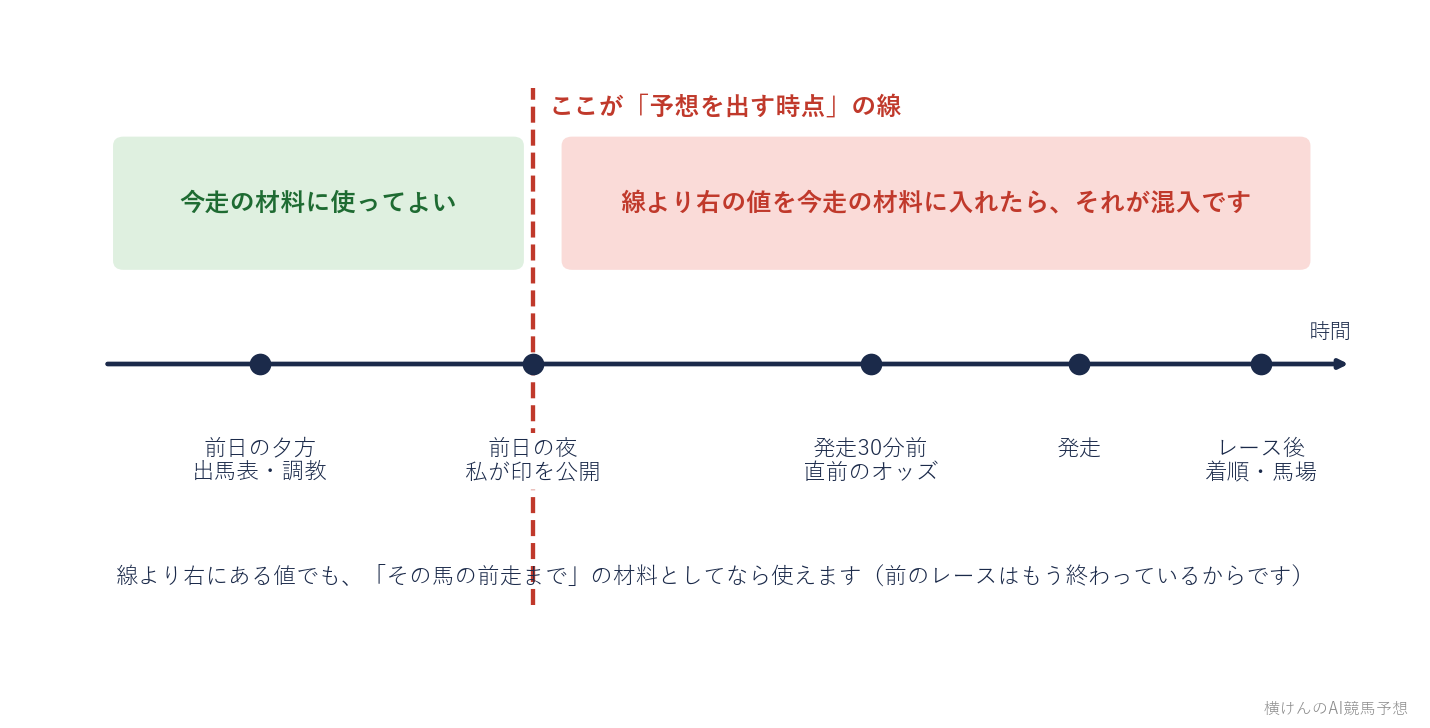
▲ 前日の夜に印を公開するので、そこが境目になります。線より右にある値を今走の材料に入れたら、それが混入です。
言葉にすると当たり前です。ところが実際のデータは、「その値がいつ発表されたか」を持っていないことがほとんどです。表の中には数字が入っているだけ。だから、発走の直前に付いた値なのか、前日の夕方に付いた値なのかは、見ただけでは区別がつきません。ここが混入の入り口になります。
そしてこの混入は、「予想が当たらない」という形では表に出ません。それらしい数字が静かに入ってくるだけです。むしろ集計上の成績は良くなるので、見つけるどころか喜んでしまいます。
単勝118.5%だった条件が、正直に測り直したら100.0%になった
いちばん背筋が寒くなったのがこれです。
私は枠順の有利不利を数値にした表を持っています。開催のコースごとに「この枠は有利」「この枠は不利」をAからEの5段階に分けた表です。これは2012年からの確定した結果、688,576行を集計して作っていて、毎週作り直しています。
ここに落とし穴がありました。毎週作り直すということは、2026年3月のレースに付いているグレードが、2026年8月までの結果を使って作られているということです。3月の時点では誰も知らない結果で、3月の枠の有利不利を決めていたわけです。
そこでAIに、2通りの付け方で数字を出させました。①いまの表でグレードを付けた場合と、②2026年の頭までの結果だけで作った表でグレードを付けた場合です。対象は2026年に私が本命(◎)を打った馬1,737頭。付け直すと、このうち20.4%の馬でグレードが変わりました。
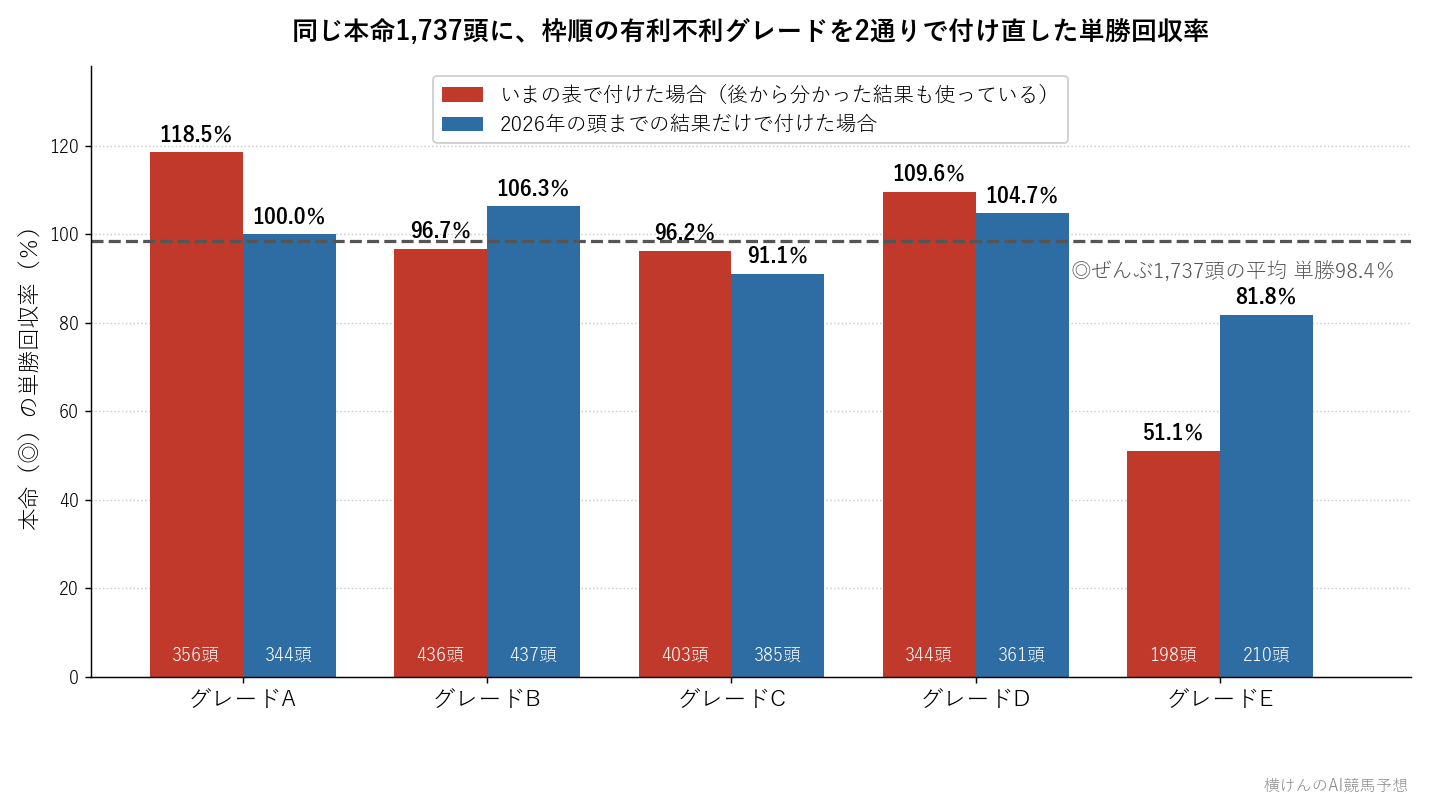
▲ 同じ本命1,737頭です。赤が「後から分かった結果も使って」グレードを付けた場合、青が「2026年の頭までの結果だけで」付けた場合の単勝回収率です。
結果はごらんのとおりです。いちばん有利なはずのグレードAは単勝回収率118.5%が100.0%へ。いちばん不利なはずのグレードEは単勝回収率51.1%が81.8%へ。勝率で見ても、Aが28.4%から25.0%に下がり、Eが10.6%から14.8%に上がりました。AとEの勝率の開きは17.8から10.2まで縮みます(ここは%どうしの引き算なので、ポイントという言い方をします)。
私が本命を打った1,737頭ぜんぶの平均は、単勝回収率98.4%・複勝回収率90.8%です。いまの表では「Aは平均より20%ぶんくらい上」に見えていたのに、正直に測り直すと「平均とほぼ同じ」になりました。AからEへの階段は、答えを知っている自分が作った階段だったということです。
表そのものも動きます。AIに数えさせたところ、枠とコースの組み合わせ1,424通りのうち、2026年の頭で切ると19.9%の組み合わせでグレードが変わり、2025年の頭で切ると31.4%で変わりました。いま『A』になっている285通りのうち33通りは、2026年の頭の時点では『B』か『C』でした。
教訓:毎週作り直す表を、過去の検証にそのまま当てない。検証したい日より後の結果が1行でも入っていたら、その集計はその分だけ良く見えます。面倒でも「その日までの材料だけで作った表」を用意して、付け直してから測ります。
「発走30分前のオッズ」が、実際には発走ちょうどのオッズだった
次は、名前と中身が違っていた話です。
私は「発走30分前のオッズ」という材料をAIに渡しています。締切直前のオッズは前日には分かりませんが、発走30分前のオッズなら、当日の買い方を考えるときの材料になります。
ところが、この値がどの時刻のものかをAIに1行ずつ数え直させたら、こうなりました。
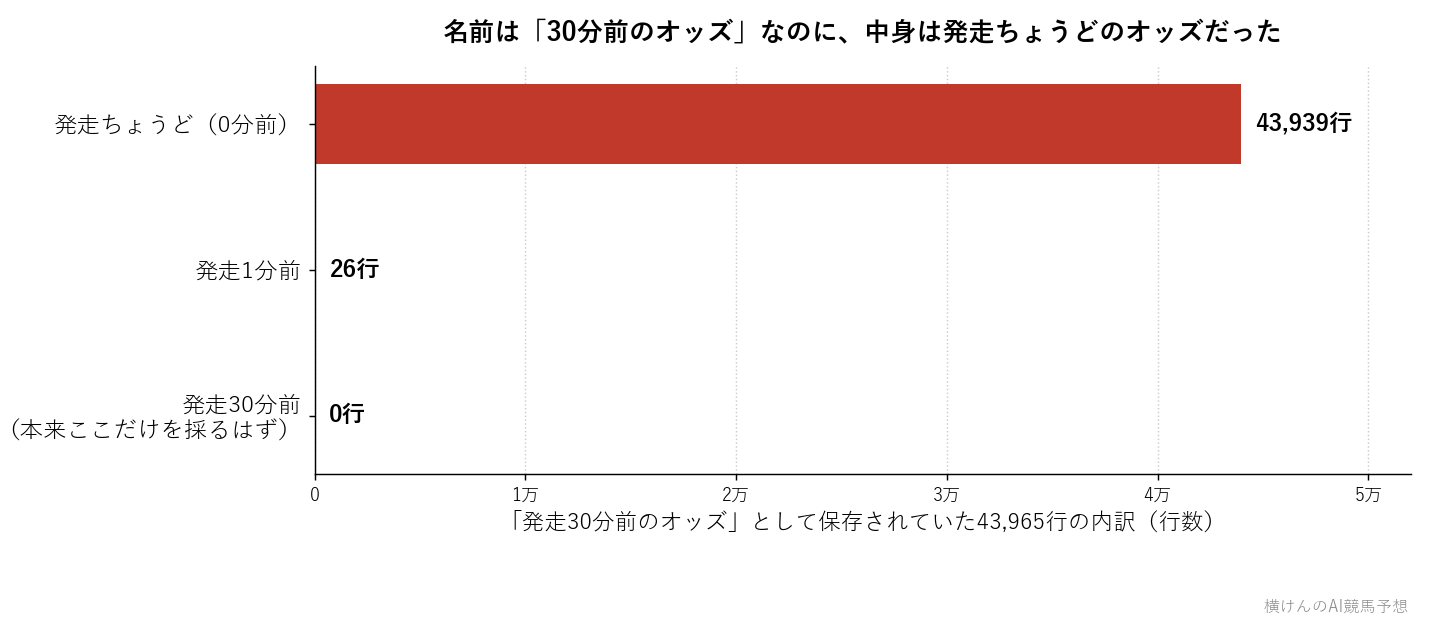
▲ 「発走30分前のオッズ」として保存されていた43,965行を、実際に値が付いた時刻で分けたものです。30分前の行は1行もありませんでした。
保存されていた43,965行のうち、発走ちょうど(0分前)の値が43,939行、発走1分前の値が26行、そして発走30分前の値は0行。名前は「30分前」なのに、中身はほぼ全部が締切間際のオッズでした。
原因は取り出す条件でした。「発走30分前から発走時刻までのあいだで、いちばん新しい値」を採る書き方になっていたのです。この書き方だと、発走30分前から発走までのあいだにオッズが動けば、必ずいちばん最後の値が採られます。つまりほぼ毎回、締切間際の値になります。
直し方はこうしました。発走の30分前【以前】に発表された値だけを対象にして、その中でいちばん新しい値を採る。ちょうど30分前の値は入れます。30分前より後の値しか無いときは、「無し」にします。黙って後の値で埋めません。16時発走のレースで4通りの材料を流して、狙いどおりに動くところまで確かめました。
| 16時発走のレースに、こう与えたら | 直したあとに採られる値 |
|---|---|
| 15時30分の4.2倍だけがある | 4.2倍 |
| そこへ15時50分と16時00分の値を足す | 4.2倍のまま(後の値は採らない) |
| 15時30分が無く、15時20分に4.7倍がある | 4.7倍 |
| 15時31分の値しかない | 採用なし |
状態は正確に書いておきます。値の取り出し方は本番で直しました。ただし、すでに保存してある2024年12月1日から2025年11月2日ぶんの値は、直しただけでは変わりません。作り直すとAIが学習する材料そのものが変わるので、学習のやり直しとセットになります。ですから予想がどれだけ良くなるかは、まだ測っていません。
教訓:列の名前を信用しない。「30分前のオッズ」という名前が付いていても、中身がその時刻のものである保証はどこにもありません。値そのものではなく、値が付いた時刻を数えると一発で分かります。
オッズが3頭ぶん欠けているのに「1番人気のオッズ」を作っていた
3つ目は、欠けているのに気づかない話です。
私は「そのレースの1番人気のオッズ」も材料にしています。ところが元のファイルでオッズが欠けている馬がいると、欠けた馬を飛ばして安い順に並べてしまう作りでした。
実例を挙げます。2026年6月7日の東京12レースは、実際に走ったのが16頭なのに、オッズが入っていたのは13頭ぶんでした。この状態で安い順に並べると、本当は2番人気の馬の値が「1番人気のオッズ」として入ります。レースの堅さ・荒れやすさを表すはずの材料が、まるごと別のレースの顔になってしまいます。
もっと悪いのは、欠けたファイルで、すでに正しく入っていた値まで上書きして消していたことです。前の週にきちんと取れていた値が、後から流し込んだ空っぽのファイルで消える。これもエラーは出ません。
直したのは次の3か所です。
- 0以下と空欄は「値なし」として扱う(0倍のオッズは存在しないので、0を値として保存しない)
- 値なしでは上書きしない(もとの値を残して、何か所残したかを画面に出す)
- 1頭でも欠けているレースでは、1番人気・2番人気のオッズを作らない(空にしたうえで、赤い印で知らせる)
教訓:欠けていることに気づかない仕組みは、静かに間違った値を作り続ける。欠けたときに止まる作りにしておけば、少なくとも「間違った値で走り続ける」ことはなくなります。
前日に無いものは、今走の材料にできない
ここまでの3つを踏まえて、私が決めた決まりがあります。
レースの前日に手に入らないデータは、今走の材料には使わない。使えるのは前走までの材料としてだけ。
たとえばパドックでの馬の気配は、発走の30分から40分前にしか出てきません。ですから「今日のこの馬の気配」は今走の材料にはできません。使えるのは「この馬は過去にチャカついたことがあるか」までです。レース後に確定する馬場の状態や着順も同じで、今走には使えませんが、前走までの材料としてなら問題ありません。捨てる必要はなくて、置き場所を変えるだけです。
この決まりを作った直後に、私は自分で破りました。恥ずかしい話ですが書いておきます。
あるデータの仕様書に「土曜日の19時ごろ更新」と書いてあるのを見て、私は「土曜19時なら土曜のレースの後だから、レース後に直された馬場の情報を掴んでしまうかもしれない」と決めつけました。ところが実際にファイルが置かれた時刻を測ってみたら、違いました。開催のデータと調教のデータの3種類について、10開催日ぶん、あわせて30ファイルの更新時刻を確かめたところ、レース日より後に更新されたファイルは1つもありませんでした。「土曜19時」は、翌日曜のレースのファイルを作る更新だったのです。
教訓:仕様書の文言で決めない。ファイルが実際に置かれた時刻を測る。危ないと決めつけて材料を捨てるのも、安全だと思い込んで混ぜるのも、どちらも同じ「測っていない」から起きます。
自分で作ったものを、自分で採点しない
ここが、いまの私のやり方でいちばん効いているところです。
この記事に書いた混入は、どれも作った本人には見つけられません。自分の作ったものを自分で採点すると、どうしても甘くなるからです。「たぶん大丈夫」で通してしまいます。
そこで今は、役割をはっきり分けています。手を動かして直すのが1つのAI、その根拠を突き返して確かめるのが別のAI。私はその間に立って、本番に入れるか入れないかだけを決めています。合格が出るまで本番には入れません。
ひとつ書き添えておくと、どの馬をどう見るかという見解は、今までどおり私が書きます。AIにやらせているのは材料集めと事実確認です。予想印や自信度のように機械が決めるところはAIが決めますが、見立てを書くのは私の仕事です。
別の目を入れると、指摘の形が変わります。「ここが怪しい」ではなく、「どの表の、どの行が、いくつずれているか」まで出てくるのです。今回の「30分前のオッズ」も、43,965行を1行ずつ数えて「30分前の行は0行です」と出してきたから分かりました。私が目で見ていたら、たぶん一生気づいていません。
そして直したあとは、わざと壊した材料を流して、検査がちゃんと止まるところまで見ます。「直しました」と「直っています」は別物だからです。今回の2か所の直しでは、機械の試験を428件(そのうち今回のために新しく作った試験が13件)通してから本番に入れました。
自分の集計に当てる3つの問い
ここまでを、そのまま使える形にまとめます。何か条件を見つけたら、買う前にこの3つを当ててみてください。
- その値は、あなたが予想を出す時点でもう発表されていましたか。発表されていないなら、その値は今走には使えません。前走までの材料に回します。
- その表は、いつまでのデータで作りましたか。検証したい日より後の結果が入っていたら、その集計は良く見えます。その日までの材料で作り直して、付け直してから測ります。
- 値が欠けたとき、黙って別の値で埋めていませんか。欠けたら止まる。埋めるなら、何を埋めたかを必ず残す。
この3つを当てるだけで、「集計では儲かるのに買うと出ない」の大半は潰せます。少なくとも私の場合は、潰せた分だけ数字が動きました。
混ざっていた分だけ、伸びしろが残っています
正直に言うと、単勝回収率118.5%だと思っていたものが100.0%だと分かったときは、がっくりきました。当てにしていた武器が1本減ったわけですから。
ただ、これは悪い話ばかりではありません。混入が見つかったということは、いま出している予想はそれに頼っていないということでもあります。実際、9月5日・6日の私の予想は、全レースで見た本命の複勝率が58.1%、複勝回収率が106%。自信度4に絞れば14頭中5勝で、勝率35.7%・単勝回収率154%・複勝回収率132%でした。混ざった数字の助けを借りずに、この成績が出ています。
そして直した材料で学習をやり直せば、ここからまだ動きます。オッズの取り出し方は本番で直し終えていて、あとは過去のぶんを作り直して学習をかけ直すだけです。穴を1つ塞ぐたびに数字は動くというのは、この3年で何度も見てきました。だから今回も、動くと思っています。
私はこのブログで、自分が先に転んでおくことにしています。118.5%が100.0%だったことも、名前と中身が違うオッズを何万行も学習させていたことも、格好は悪いですが全部書きます。私が転んだぶんだけ、これを読んでくださっている方は同じ穴を踏まずに済むからです。
混入は、探しにいった人にしか見つかりません。今週も探しにいきます。見つかったらまた、毎週この場所で数字のまま書きます。
この内容を実際に使った週の実戦記録(買い目と収支つき)はこちらです。→ ChatGPT6アストラ×競馬予想|検証と改善を強化した1週間
コメント