競馬予想AIを自分で作っていると、毎週のように「良くなった」という数字が出ます。新しい材料を1本入れて、成績がわずかに上がる。ここで喜んで採用してしまうと、何が起きるか。
その大半は、まぐれです。
私は3,534回ぶんの測定を数え直して、それをはっきり確かめました。当時の私の基準で拾っていた379本のうち、約74本(20%)はまぐれだったという計算になります。5本に1本がゴミです。
この記事では、私が実際に使っている「その改善は本物か」を確かめる3つの検査を、実測値ごと公開します。競馬に限らず、データで何かを判断している人には同じ話が使えるはずです。
▶ 私が毎週150万円を賭けながら3年かけて作った競馬予想AIの全体像は、「競馬予想AIの作り方・完全ガイド」に最初から順にまとめています。
なぜ「良くなった」は信用できないのか
理由は単純で、AIの学習には毎回わずかな揺れがあるからです。まったく同じデータでも、内部の乱数を変えると結果は少しだけ変わります。
つまり「+0.0002だけ良くなった」という数字は、材料が効いたのか、たまたま揺れただけなのか、それだけでは区別がつきません。意味のないデタラメな列を足しても、+0.0004くらいの「改善」は普通に出ます。私はこれを実際に確かめて、肝を冷やしました。
だから必要なのは「良くなったか」ではなく、「揺れの範囲を超えて良くなったか」という問いです。
検査1:1本ずつではなく、まとめて足して、乱数のブレと比べる
1つめの検査は、改善の幅を「乱数を変えたときのブレ幅」と並べて見ることです。
下は、私が今週入れた基本の材料19本(レースの頭数・斤量・性別・クラス・脚質など)を、まとめて足したときの実測です。
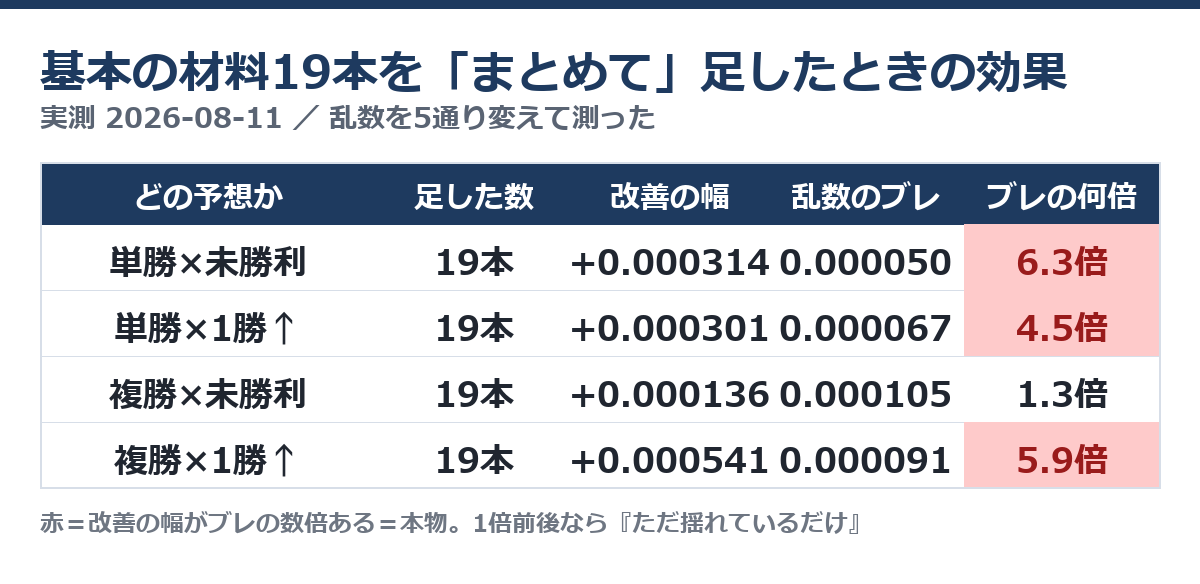
見るのは一番右の列です。改善の幅が、乱数のブレの何倍あるか。4.5倍から6.3倍あれば、揺れでは説明がつきません。逆に1.3倍しかない場所は、正直に「まだ分からない」と扱います。
ここで大事なのが、1本ずつではなく、まとめて足して測ることです。実際、この19本のうち基本の4本だけを足したときは、未勝利戦の成績はむしろ悪くなっていました。19本そろえて初めて、全部の場面でプラスに転じています。
私のやり方は「強烈に儲かる1本」を探すのではなく、薄い信号を何本も束ねることです。だから測るときも、1本ではなく束で測らないと合いません。
検査2:本命が入れ替わったレースだけを取り出す
2つめが、たぶん一番効きます。
全体の精度がわずかに上がっても、それが馬券の役に立っているとは限りません。私が知りたいのは「予想全体の平均」ではなく、「本命が変わったなら、変わった先は当たったのか」です。
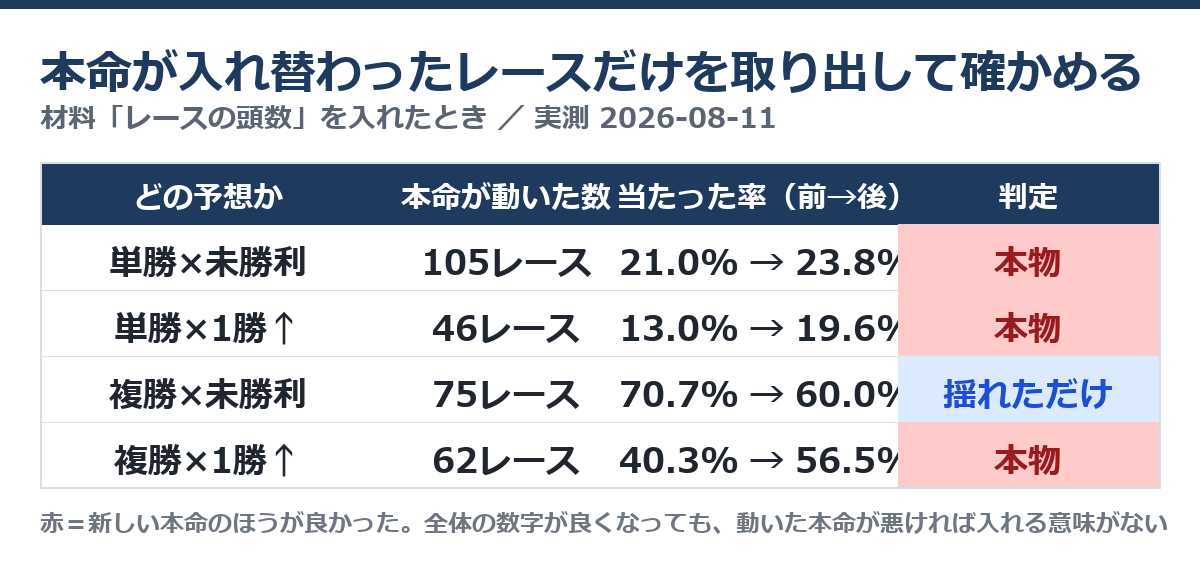
やり方は簡単で、材料を入れる前と後で本命が入れ替わったレースだけを抜き出し、新しい本命のほうが良かったかを数えるだけです。
上の表は「レースの頭数」という材料を入れたときのものです。105レースで本命が動いて、当たった率は21.0%→23.8%。1勝クラス以上では13.0%→19.6%。ここは本物と判断しました。
一方で、未勝利戦の複勝予想では70.7%→60.0%と下がっています。全体の数字だけ見ていたら、これは絶対に気づけません。同じ材料でも、場面によって効いたり効かなかったりするということです。
私が実際にやってしまった失敗もあります。予想全体で見ると問題なかった材料が、本命が動いた先だけを見ると勝率が21.7%から20.4%に落ちていたことがありました。全体では安全なのに、一番大事なところで悪くなっていたわけです。ただ、これは裏を返せば「見る場所さえ決めておけば事前に気づける」ということでもあります。全体の数字だけを見ていたら一生気づけませんが、動いた本命だけを数えるのは1分で終わります。
検査3:「拾ったうち何本がまぐれか」で線を引く
3つめは、線の引き方そのものの話です。
私は候補を機械で大量に試しています。3,534回。ここまで数を撃つと、何も効いていなくても、たまたま良い数字が出るものが必ず混ざります。
そこで「改善が◯以上なら採用」という線を、拾ったもののうち何本がまぐれになるかから逆算しました。
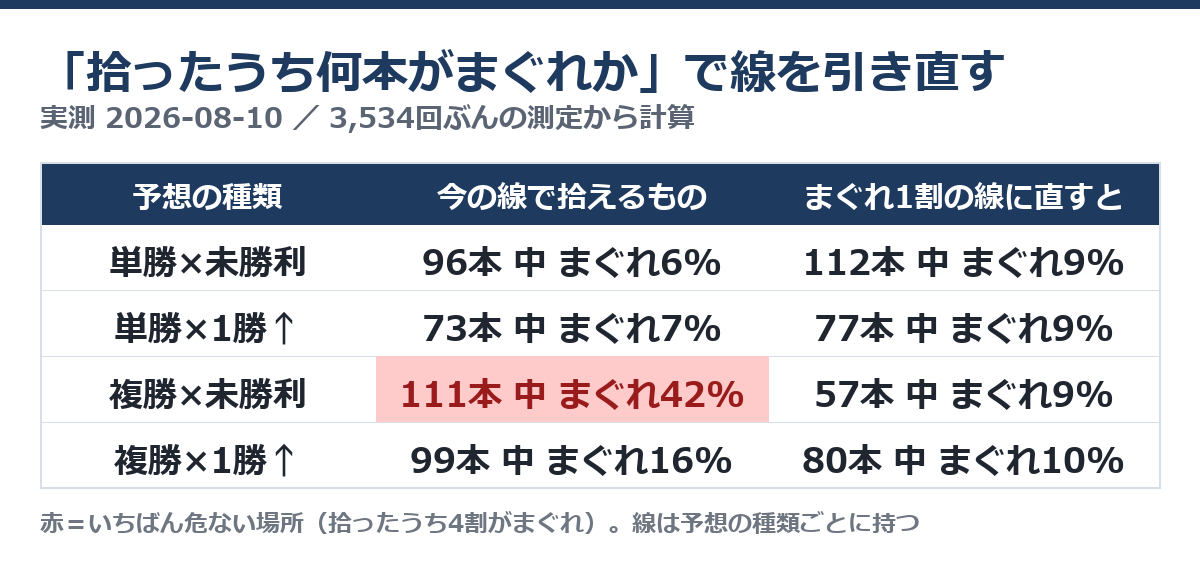
結果は、私にとってかなり意外なものでした。
まず未勝利戦の複勝予想が最悪で、当時の線だと111本拾えるものの、そのうち42%がまぐれという計算でした。ここは線を上げて57本まで絞る必要がありました。
ところが単勝の予想では逆で、線が厳しすぎました。線を下げても、まぐれの割合は6%→9%にしか増えません。それで16本も多く拾える。つまり私は、拾えるはずの薄い信号を捨てていたことになります。
ここから学んだのは、線を1本に固定してはいけないということです。単勝と複勝、未勝利と1勝クラス以上では、そもそも当たりやすさが違います。混ぜて1本の線で切ると、必ずどちらかが損をします。
私がやっていた、いちばん恥ずかしい間違い
正直に書いておきます。
私は長いあいだ、「改善の平均」を「乱数を変えたときのブレの幅(最大−最小)」と比べていました。一見すると慎重で正しそうに見えます。
でもこれは間違いです。ブレの幅は、試す回数を増やすほど広がります。5回試せば5回ぶん、10回試せば10回ぶん広がる。だから「回数を増やすほど基準が厳しくなる」という、おかしなことが起きていました。
計算すると、実質8倍くらい厳しく判定していたことになります。良い材料をいくつも捨てていた可能性が高い。
この間違いに気づいたのは、自分でおかしいと思ったからではありません。「採用基準、きびしすぎてませんか」と言われて、測り直したからです。判定装置を作った本人は、その装置を疑いません。ここは本当に気をつけたほうがいいところだと思いました。
それでも「作った=採用」ではない
最後に、いちばん大事な前提を書いておきます。
この3つの検査は、「そこから先を調べる価値があるか」を決めるための入口にすぎません。ここを通っただけでは採用しません。
そのあとに、本番と同じ束の上に乗せても効くか(単独で効いても、他の材料と重なっていれば消えます)、年ごとに符号がそろっているか、デタラメ版と同時に走らせて差が出るかを通します。
逆に言うと、ここまでやって残ったものだけが束に入ります。私のやり方は「1本で回収率100%を目指す」のではなく、独立した薄い信号を何十本、何百本と束ねていくことです。1本の汚染で束は全部おかしくなるので、入口の検査を甘くすると、あとで全部が壊れます。
まとめ
- 「良くなった」だけでは何も分からない。デタラメな列でも改善は出る
- 検査1=改善の幅を、乱数を変えたときのブレと比べる。数倍あるか
- 検査2=本命が入れ替わったレースだけを抜き出し、新しい本命のほうが良かったかを見る
- 検査3=拾ったうち何本がまぐれになるかで線を引く。線は場面ごとに持つ
- ブレ幅と比べる比べ方には落とし穴がある(試す回数で広がる=厳しくなりすぎる)
- この3つを通っても、まだ採用ではない。束の上での検証がそのあとに来る
地味な作業です。強烈に儲かる手法を探すほうが、たぶん楽しい。ただ私は、楽して儲けたい人が一生たどりつけない急がば回れをやると決めているので、この検査だけは省きません。
この内容を実際に使った週の実戦記録(買い目と収支つき)はこちらです。→ 穴狙いが沈む「堅い週」の正体|41万円マイナスの全データを公開
ここを丁寧にやるだけで、差はつきます
地味な作業だと書きました。それは事実です。
ただ、裏を返せばこれは非常に良い話でもあります。ここまで機械で確かめている人は、ほとんどいません。才能でも資金力でもなく、手順の問題だからです。「良くなった気がする」で採用している人が大半のなかで、まぐれを弾く仕組みを1つ持つだけで、積み上がり方がまるで変わります。
実際、この3つの検査を通したことで、私は捨てるはずだった16本を拾い直し、拾うはずだった57本を捨てました。どちらも、測らなければ気づけないものでした。
私はこれを毎週回して、束ねる信号を1本ずつ増やしています。うまくいったものも、外したものも、失敗の経緯まで含めて全部このブログに書きます。同じことを一から自分で確かめると3年かかります。ここを読んでいただければ、その3年は要りません。
▶ あわせて読みたい:牝馬は立て直せないのか|3走続けて負けた1万8千頭の追跡結果
▶ あわせて読みたい:減量騎手が乗る馬は不利か|25万頭を同じ人気で比べた3着内率
コメント