こんにちは、横けんです。毎週150万円を自分のお金で馬券に使いながら、競馬予想のAIを自分で作っています。
私は競馬予想AIのプログラムを、Claude Code(クロードコード)というAIに書かせてきました。書くのは速いし、直すのも速い。ただ、ずっと引っかかっていたことがあります。作ったAIに「間違いはありませんか?」と聞いても、なかなか自分の間違いは出てこないのです。
あなたも、自分で書いた文章の誤字を、自分ではなかなか見つけられなかった経験はありませんか? AIも同じだと、私は感じています。
そこで私は、作る役とは別に、間違いを見つける役としてCodex(コーデックス)のGPT-6 Astraを入れました。作る実行部隊はClaude Code、チェック役・見張り・間違いの指摘はCodexのGPT-6 Astra。この形にしてから開発がとてもうまく回るようになったので、両方と契約することにしました。
では、Codexは実際にどんな間違いを見つけたのか? この記事は、Codexをチェック役にして、9月6日・7日に私の側で裏を取った23件の指摘の中身と、私がなぜClaude CodeとCodexを両方使うことにしたのかをまとめたものです。
- 作る・直すのはClaude Code、見張って間違いを指摘するのはCodexのGPT-6 Astra。本番に入れるかどうかは私が決めます
- Claude Code同士で間違いを探させるのには限界がある、というのが私の実感です
- Codex(GPT-6 Astra)に5回チェックさせて出た指摘は23件、そのうち15件が本物でした
- いちばん大きかったのは、レースが終わってからの確定オッズが、予想の記録に入り込む道。11開催日・312レースで、オッズが確定オッズと1円単位まで一致していました
- Codexの指摘も、そのまま信じない。23件のうち8件は、言い過ぎや証拠の誤りなどで、そのままは直していません
▶ 私が毎週150万円を賭けながら3年かけて作った競馬予想AIの全体像は、「競馬予想AIの作り方・完全ガイド」に最初から順にまとめています。
Codexとは何か? Claude Codeとどう使い分けているのか?
先に、公表されていることと、私の使い方を分けて書いておきます。
Codexは、ChatGPTを作っているOpenAIが出しているAIで、公式の説明では「手元のパソコンで動く、プログラムを書くためのAI」です。Claude Codeは、Anthropic(アンソロピック)という別の会社のAIです。つまり私は、別々の会社が作った2つのAIを使っていることになります。
私はCodexで、GPT-6 Astra(アストラ)を使っています。先々週の記事「ChatGPT6アストラ×競馬予想|検証と改善を強化した1週間」で「アストラ」と書いたのが、これです。
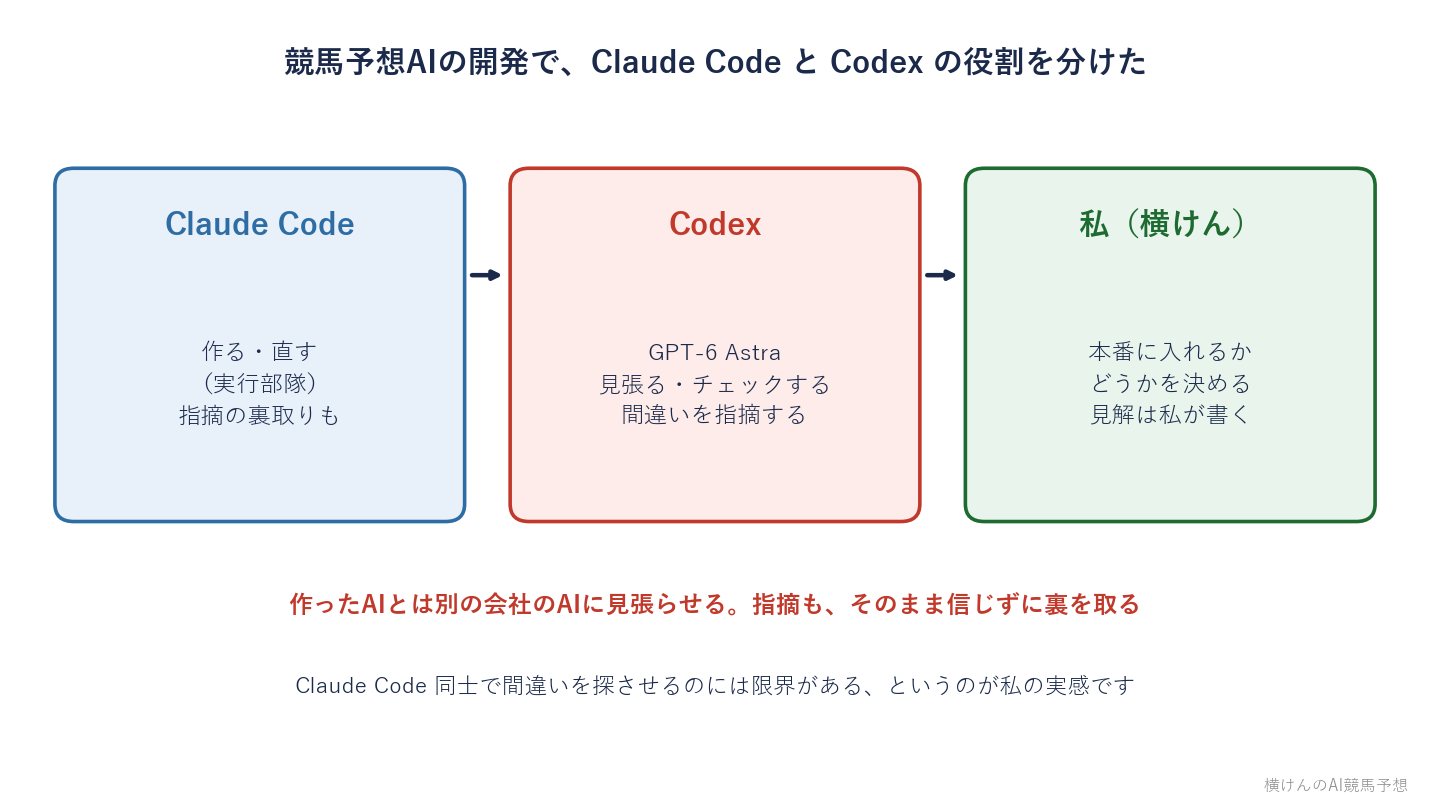
▲ 私の開発の役割分担です。Claude Codeが作って直し、Codexが見張って間違いを指摘し、最後に私が本番に入れるかどうかを決めます。
役割はこうです。
- Claude Code=実行部隊。プログラムを書く、直す、データを集計する。Codexの指摘が本当かどうかを、実データで確かめるのもClaude Codeの仕事です。
- Codex(GPT-6 Astra)=チェック役・見張り。Claude Codeが作ったものを読んで、「ここがおかしい」「この証拠を出せ」と突き返します。自分では直しません。
- 私=決める役。本番に入れるか入れないかを決めます。予想の見解を書くのも、今までどおり私です。
お金の話も正直に書いておきます。Claude CodeとChatGPTに、それぞれ毎月4万円くらい、合わせて8万円くらい使っています。高いと思いますか? 安くはありません。それでも両方に払う理由を、ここから書いていきます。
なぜClaude Code同士で間違いを探させるのではダメなのか?
最初は、Claude Codeに作らせて、別のClaude Codeに確かめさせていました。これでも見つかる間違いはあります。ただ、使っているうちに限界を感じるようになりました。
同じ会社の同じ系統のAIは、考え方の癖も似ている、というのが私の実感です。作った側が「ここは大丈夫」と思い込んだところを、確かめる側も同じように「大丈夫」と通してしまう。人間でいえば、同じ塾で同じ教わり方をした2人に、お互いの答案を採点させているようなものです。
競馬の予想でも同じことが言えませんか? 同じ新聞の同じ記者の印ばかり見ていると、その記者が見落とした馬は、自分も見落とします。違う物差しを持った人の意見を1つ入れるだけで、見え方が変わります。
だから私は、作る役と見つける役を、別の会社のAIに分けました。ここから先は、実際にCodexが見つけた間違いの中身です。
Codexに5回チェックさせたら、指摘は23件。そのうち本物は15件
私はCodexに、競馬予想AIのプログラムを何回にも分けてチェックさせています。そのうち、9月6日と7日に私の側で裏を取った第2回から第6回までの5回ぶんを数えました。
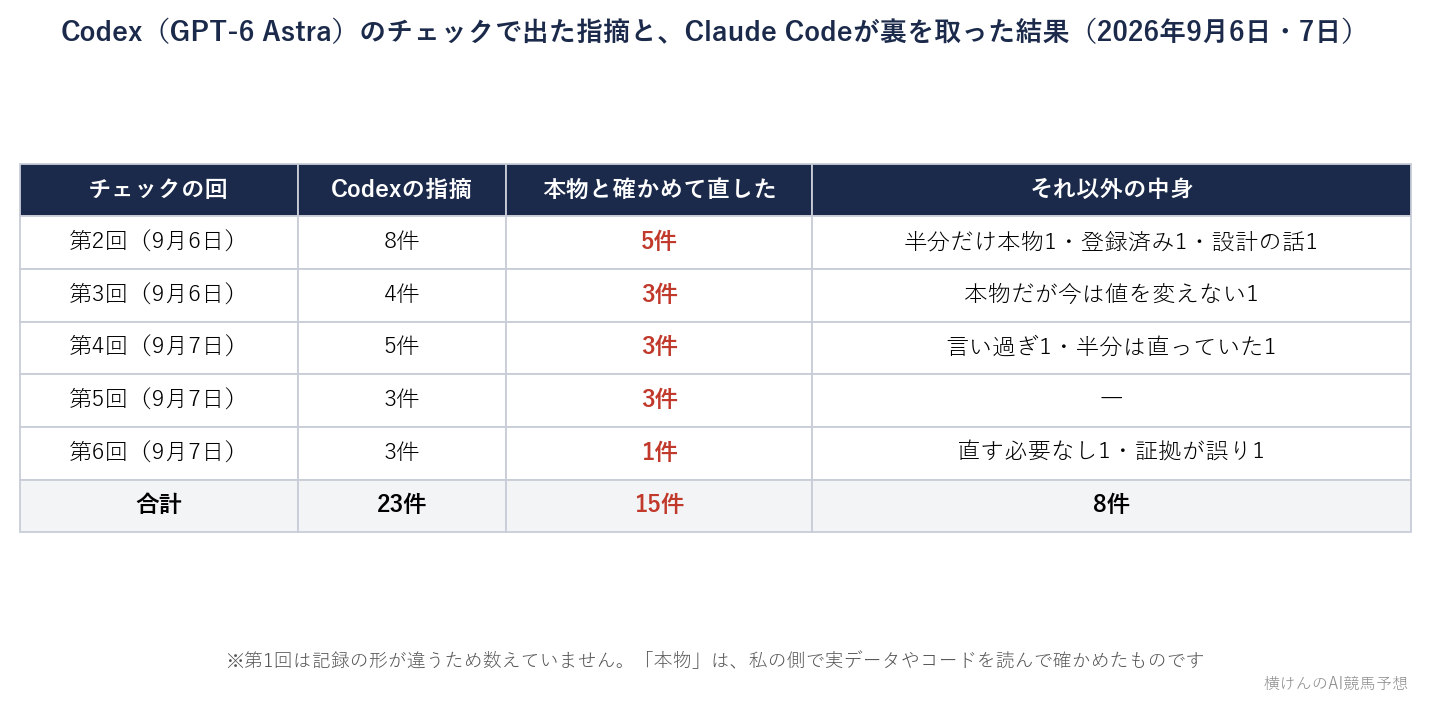
▲ Codexに5回チェックさせて出た指摘の数と、そのうちClaude Codeが実データやプログラムを読んで「本物」と確かめて直した数です。23件のうち15件が本物でした。
あなたは、23件の指摘のうち、いくつが本物だったと思いますか? 数えてみると、指摘が23件、そのうち本物と確かめて直したのが15件です。残りの8件は、「本物だが今は値を変えない」「言い過ぎ」「証拠が誤り」などでした。この8件の話は、あとの章で書きます。
15件の中から、とくに大きかった3つの間違いを挙げます。
1つ目:レースが終わってからの確定オッズが、予想の記録に入り込んでいた
私の予想では、「発走30分前のオッズ」を材料の1つにしています。ところがCodexは、この欄に、レースが終わったあとの確定オッズが上書きされる道があると指摘してきました。
Claude Codeに裏を取らせると、指摘より悪い話でした。道があるだけでなく、実際に起きていたのです。過去の予想エクセルを調べると、オッズが確定オッズと1円単位まで完全に一致した開催日が11日・312レースありました。ふつうの日なら、偶然一致するのは0〜6%だけです。ほかにも、混入が一部に見つかった開催日が7日・229レースありました。
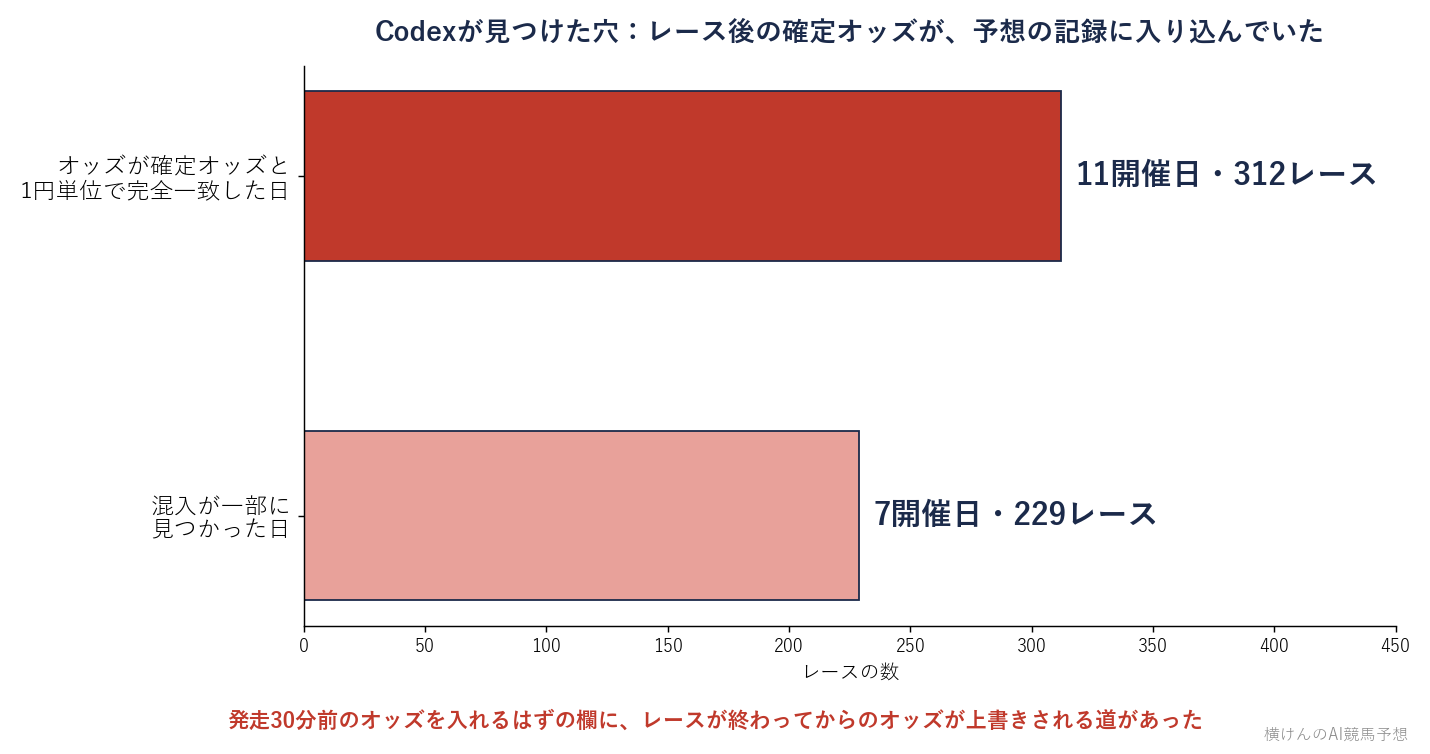
▲ Codexの指摘をきっかけに、過去の予想エクセルを調べた結果です。オッズが確定オッズと1円単位で完全に一致した開催日が11日・312レース、混入が一部に見つかった開催日が7日・229レースありました。
しかもこの道は、本来の役目も果たしていませんでした。発走前には何も返さない仕組みだったので、返ってくるのはレース後に予想を作り直したときだけ。役に立たないうえに、答えを混ぜる道だったわけです。この道は閉じ、過去の日の予想を作り直したときは、本番の記録とは別の場所に保存するようにしました。
正直に書くと、この混入で成績がどれだけ良く見えていたのかは、測っても決着がついていません。混入した日と正常な日を比べると、単勝と複勝で差の向きが逆になり、どちらとも言えないからです。ただ、レース後の答えが予想の記録に混ざる道が開いていたこと自体が、あってはならない穴でした。
2つ目:血統の成績が、本来使うべき月の値になっていなかった
私のAIは、父の成績などの血統の材料を「月ごと」に集計して使っています。学習のときは、そのレースの月の値を使います。ところがCodexは、予想するときだけ、馬ごとに最後に記録された値を使っていると指摘しました。休み明けの馬ほど、古い値になります。
Claude Codeに測らせると、9月6日の予想で、父の成績の値が本来使うべき月の値と一致していた馬は、450頭のうち58.3%だけでした。4割の馬で、学習のときと違う物差しで予想していたことになります。予想するときも、学習と同じ月の値を使うように直しました。
3つ目:新しいモデルと古い補正が組み合わさる恐れがあった
私のAIは、学習を終えたモデル(予想を出せる状態になったAIのことです)と、そのモデルが出す確率を実際の成績に合わせて補正する部品を、セットで使っています。Codexは、この2つが別々のタイミングで保存されていると指摘しました。途中で何か失敗すると、新しいモデルに古い補正が付いたまま予想が出る恐れがあります。
これも本物でした。補正を先に作ってから、2つを続けて置き換える形に直し、2つに同じ目印を付けて、予想するときに組み合わせが合っているかを確かめるようにしました。
どれも、エラーが出ない種類の間違いです。予想はふつうに出てきます。作った本人が「動いているから大丈夫」と思っているところに、別の目が入って初めて見つかったものでした。
Codexの指摘も、そのまま信じていいのか?
ここが大事なところです。Codexの指摘も、全部が正しいわけではありません。23件のうち8件は、そのままは直していません。
たとえば第6回のチェックで、Codexは「学習ではほとんど埋まっている材料が、本番では全部空になっている」と指摘してきました。Claude Codeに確かめさせると、Codexが証拠に挙げたのは、15頭全員が初めて走る新馬戦の記録でした。過去のレースが1つもない馬ばかりなので、過去の成績の材料が空なのは正しい姿です。ふつうのレースで測り直すと、14頭のうち過去に走ったことがある12頭には、きちんと値が入っていました。
第4回のチェックでは、「開催が食い違ったときに、別のレースの材料を使い回す道があるので、その道ごと廃止せよ」という指摘がありました。穴があるのは本物でした。ただ、この道には、同じ開催日の中で回次や日次がずれたときに正しいレースを拾い直す、という正しい使い道もあります。そこで廃止はせず、日付が違うときだけ使わないように直しました。
つまり私のやり方は、こうです。
- Codexが間違いを指摘する
- Claude Codeが実データとプログラムで裏を取り、「本物」「言い過ぎ」「証拠が誤り」に分ける
- 本物なら直し方を決めて、私が本番に入れるかどうかを決める
Codexにも、作った側のClaude Codeにも、どちらにも最後の判断は任せません。2つの違う目で突き合わせるから、どちらかの思い込みが残りにくくなります。
このチェックは、新しい印の決め方を本番に入れるときにも使いました。Codexのチェックで指摘が7件返ってきて、そのうち2件は予想そのものが変わりかねない重大なものでした。何度も差し戻されて直し、137項目すべてに合格してから本番に入れています。
あなたがAIで何かを作るなら、どうすればいいのか?
ここまでの経験から、AIに作業を任せるときに私が決めていることを、そのまま使える形にまとめます。
- 作るAIと、確かめるAIを分ける。できれば別の会社のAIにします。考え方の癖が違う相手のほうが、見落としを拾ってくれます。
- 確かめる役には、直させない。指摘だけさせます。直す役まで持たせると、自分の直しを自分で採点することになります。
- 指摘も裏を取る。「本物」「言い過ぎ」「証拠が誤り」に分けてから直します。
- 最後に決めるのは自分。AIが合格と言っても、本番に入れるかどうかは自分で決めます。
競馬予想AIに限りません。AIに文章や集計を任せているなら、同じ形がそのまま使えるはずです。この秋に私が見つけた「AIの報告の確かめ方」は、週次の記事「人気馬の本命はAIに任せない|土日40レースで決めた方針」にも書いています。予想より後の数字が混ざる話は「競馬データ検証の罠」に詳しく書きました。
見つかった穴の数だけ、予想はまだ強くなれる
正直に言うと、確定オッズが予想の記録に混ざっていたと分かったときは、背筋が寒くなりました。自分のAIを信じてお金を張っているわけですから。
それでも、悪い話ばかりではありません。こうした穴をふさいでいる最中の9月12日・13日の2日間でも、予想を出した40レース全部で見た本命(◎)の単勝回収率は108%、いちばん勝負している自信度5に絞れば10レースで4勝・単勝回収率205%でした。Codexが見つけた15件の穴を1つずつふさいだ分だけ、ここから積み上げられる余地が残っています。
見立てを書くのは今までどおり私の仕事で、AIに任せているのはプログラムと材料集めと事実の確認です。だからこそ、作るAIと見張るAIの両方にお金を払っています。確かめた材料だけで、予想を組み立てたいからです。
Codexが次にどんな穴を見つけるのか、私も楽しみにしています。見つかったら、見つかったそのままの数字で、この場所に書いていきます。私が先に穴を踏んでおけば、あなたは同じ穴で時間とお金を失わずに済みます。
コメント